2026年11月10日、ザ・プリンスパークタワー東京でNVIDIAが開催した「Agentic AI Day Japan 2026」で、株式会社スクウェア・エニックスの藤井翔太氏※による「ゲーム開発プラットフォームにおける生成AIの実装」と題した講演が行われた。
※2024年4月に新卒で入社し、AI&エンジン開発ディビジョンで生成AIとテクニカルアーティスト(TA)の両チームを兼任
藤井氏は、手元のGPUで動かす大規模言語モデル(ローカルLLM)が、ゲーム開発の作業をどこまで担えるかを「NVIDIA Nemotron 3.5 Super VL」で検証し、結果を報告した。発表内容は同社の業務での活用ではなく、藤井氏が個人で行った検証である。
開発費・人件費・AI利用料金の課題感が、ローカルLLMを検討する出発点に
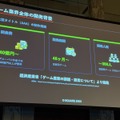
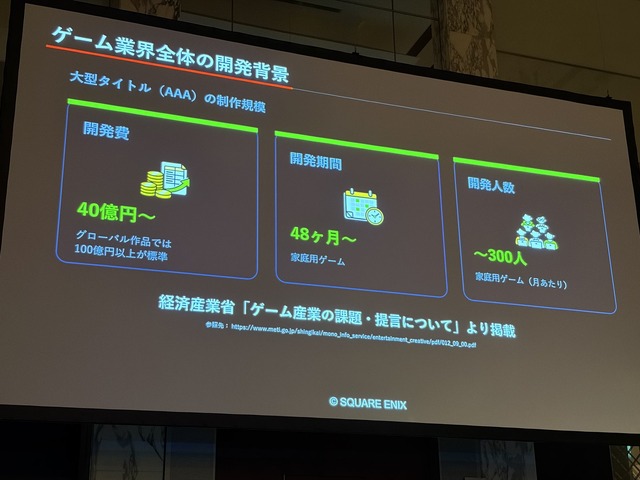
藤井氏はまず、ゲーム業界の開発規模を示した。経済産業省の資料「ゲーム産業の課題・提言について」によると、大型タイトル(AAA)の開発費は40億円から、グローバル作品では100億円以上が標準である。開発期間は家庭用ゲームで48か月から、開発人数は家庭用ゲームで月あたり300人に及ぶ。
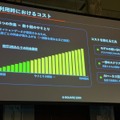
人件費も上がっていることに加え、AIの利用料にも課題感がある。1つの作業は数十回のやりとりで構成される。やりとりのたびにセッションデータ(それまでの会話の履歴)が積み上がるため、料金は増え続ける。ゲーム開発では、正解のない企画を何度も試すこと、高解像度の画像や動画を大量のトークンに変換して入力することが、費用をさらに押し上げるという。
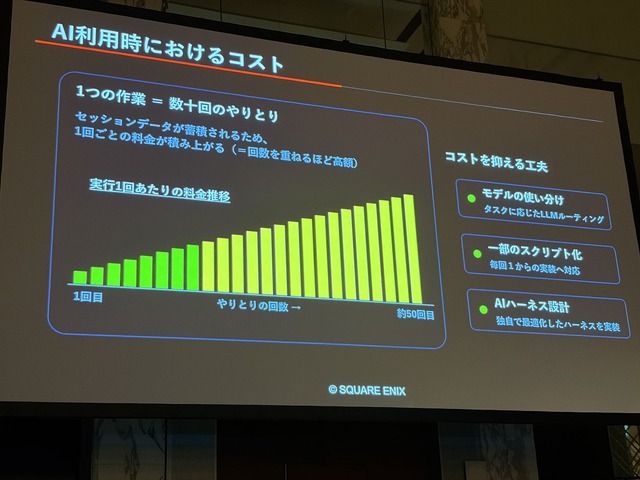
対策として藤井氏は、タスクの難しさに合わせてモデルを使い分けるLLMルーティング、一部の処理のスクリプト化、AIを動かす周辺の仕組みを最適化するAIハーネス設計の3つを挙げた。その先の選択肢がローカルLLMである。利点は、機密データを社内で処理できる安全性、クラウド側のモデル更新で出力品質が変わる事態を避けられる一貫性、外部APIへの依存を減らせる可用性の3点だと説明した。
検証に使ったのは、Attentionを8層に絞ったNemotronである
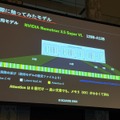
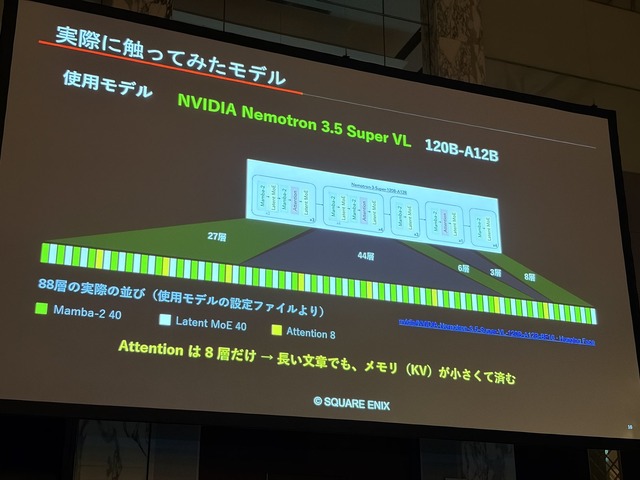
検証に使った「NVIDIA Nemotron 3.5 Super VL」は、画像や動画も扱えるビジョン・ランゲージモデルで、型番は120B-A12Bである。88層の内訳はMamba-2が40層、Latent MoEが40層、Attentionが8層だ。藤井氏は、Attentionが8層だけのため、長い文章でもメモリ(KV)が小さくて済む点を特徴に挙げた。
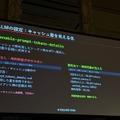
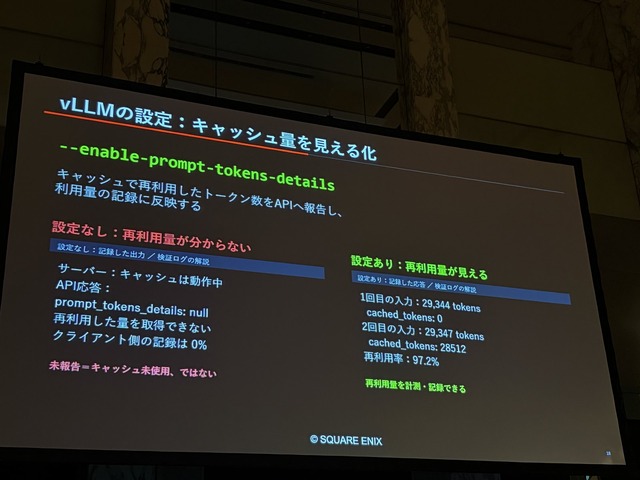
運用面では、推論フレームワークのvLLMに「--enable-prompt-tokens-details」を付ける設定を紹介した。設定がないと、サーバー側でキャッシュが動いていても、APIの応答から再利用した量が分からない。設定ありの例では、1回目の入力29,344トークンに対し、2回目は29,347トークンのうち28,512トークンを再利用し、再利用率は97.2%だった。ログを積み上げて動くAIエージェントでは、この計測が役に立つと藤井氏は述べた。
簡単な質問ではNemotronが最短、難しくなると差が縮まった
検証は、チャット、スクリプト生成、モーション生成、MCP連携の順に難しくなる4段階で行われた。
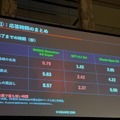
最初のチャットでは、3つのお題の応答時間を、NVIDIA Nemotron 3.5 Super、GPT-6.1 Sol、Claude Opus 5.5で比べた。各お題3回の中央値は次のとおりである。「世界最高峰の名前」はNemotronが0.79秒、GPT-6.1 Solが1.42秒、Claude Opus 5.5が2.95秒だった。「AABBの数式」は5.63秒、2.42秒、4.22秒、「2Dゲームの案出し」は8.57秒、3.37秒、6.00秒である。Nemotronが最短だったのは、最も易しい質問だけだった。なお、ClaudeはCLIの起動時間を含むため、モデル単体の速度比較ではないと、スライドに注記されている。
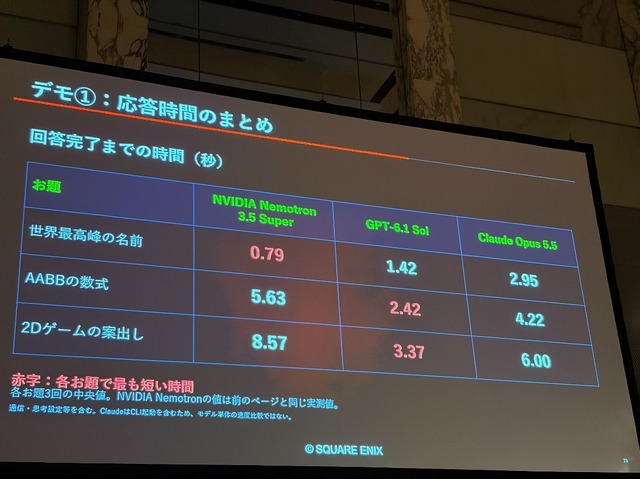
藤井氏は、質問の難しさによって速度の差が変わるため、簡単なチャットではローカルモデルを導入しやすいとの見方を示した。
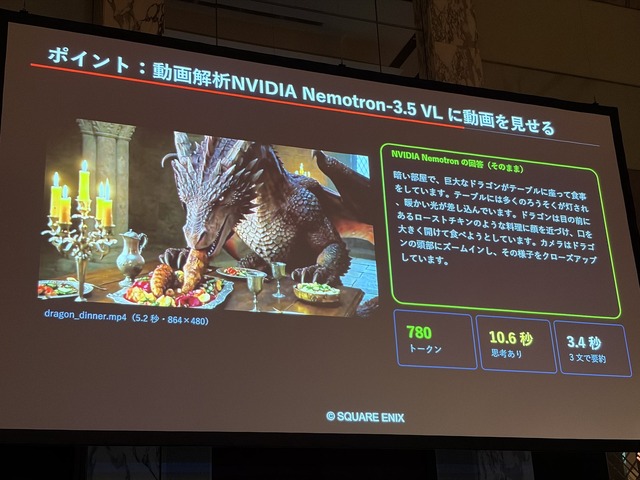
動画の理解も試した。5.2秒、864×480ピクセルの「ドラゴンの食事」の動画を読み込ませると、暗い部屋で巨大なドラゴンが食事をし、カメラが頭部にズームインする様子を正確に説明した。出力は780トークンで、思考ありで10.6秒、3文要約で3.4秒だった。
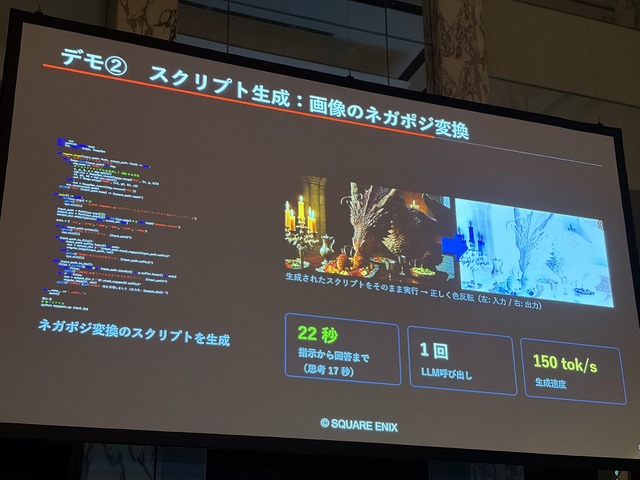
スクリプト生成では、画像のネガポジ変換を行うPythonスクリプトを、LLMの呼び出し1回で生成した。指示から回答まで22秒(うち思考17秒)、生成速度は150トークン/秒である。生成されたスクリプトをそのまま実行すると、画像は正しく色反転した。
HTMLとJavaScriptで、移動やジャンプ、攻撃の判定を備えた簡易ゲームも1回で出力している。
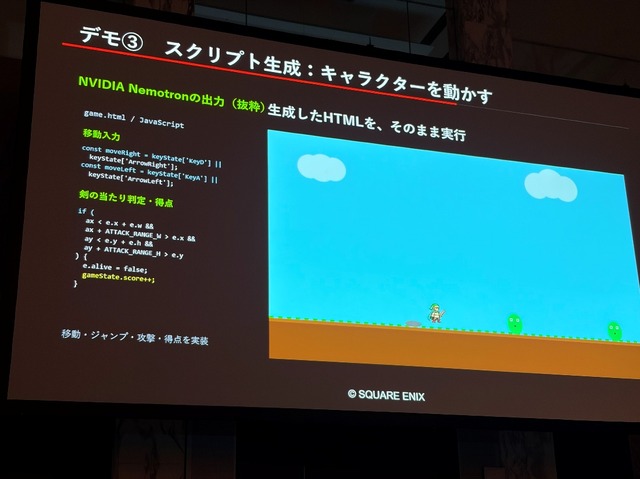
藤井氏は、難易度の低いテストだったと断った上で、出力の速さはChatGPTやClaudeのほうが上だったと述べた。
モーション生成では、キーの置き方が品質を左右した
応用検証の1つ目はモーション生成である。Unreal Engineの環境で、キャラクターがバーをくぐる、台に登る、溝をジャンプで越えるといった動きを作った。
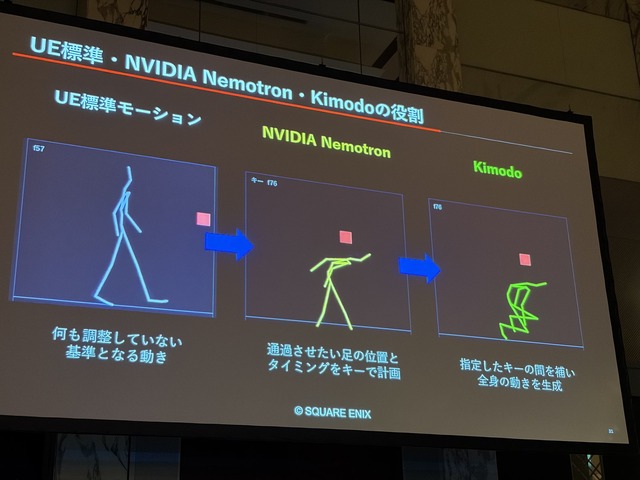
役割は3段階に分かれる。まずUnreal Engine標準の歩行モーションを基準とする。次にNemotronが、通過させたい足の位置とタイミングを、キーフレームとして計画する。最後に、NVIDIAのモーション生成モデルKimodoが、指定されたキーの間を補い、全身の動きを生成する。
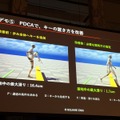
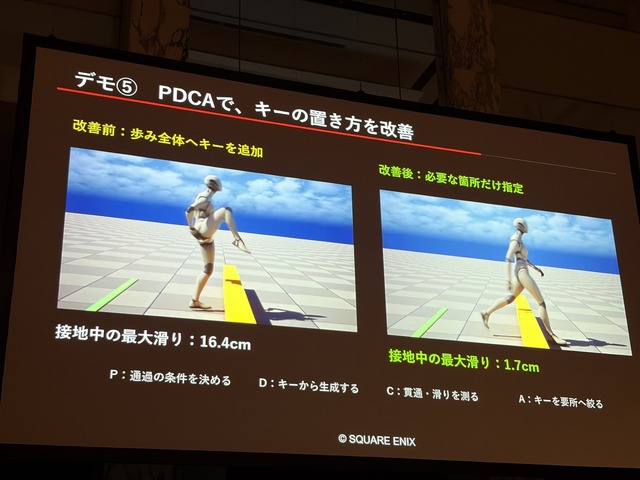
出来上がった動きには足の滑りが残った。そこで藤井氏は、PDCAを回してキーの置き方を直した。通過の条件を決め、キーから動きを生成し、貫通と滑りを測り、キーを要所に絞る流れである。接地中の最大滑りは、改善前の16.4cmから1.7cmに縮まった。
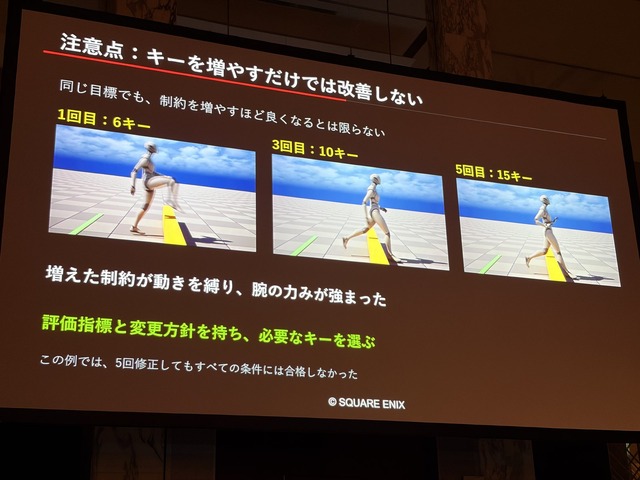
一方で、キーを増やせば良くなるとは限らなかった。同じ目標で、1回目は6キー、3回目は10キー、5回目は15キーを指定したところ、増えた制約が動きを縛り、腕の力みが強まった。この例では、5回修正してもすべての条件には合格しなかった。藤井氏は、評価指標と変更方針を持った上で、必要なキーを選ぶ必要があると述べた。
MCP連携と振り分けで、作業の28%をローカルが担った
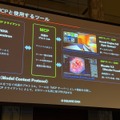
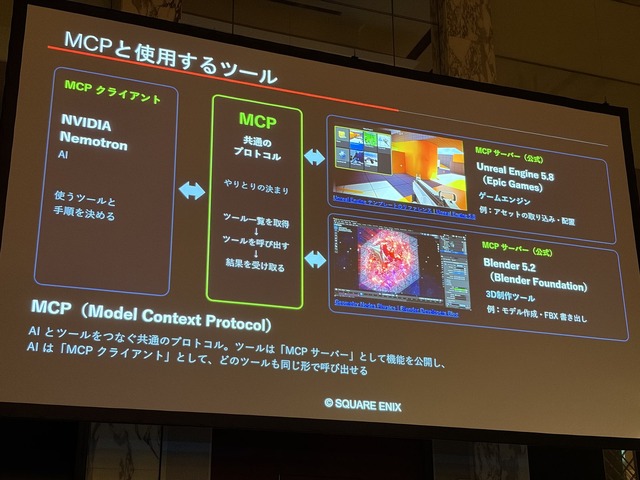
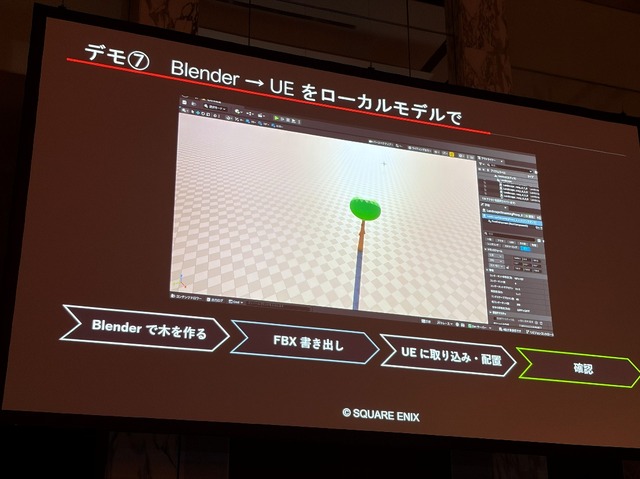
2つ目の応用検証がMCP(Model Context Protocol)である。AIとツールをつなぐ共通のプロトコルで、ツールがMCPサーバーとして機能を公開し、AIがMCPクライアントとして呼び出す。検証では、Unreal Engine 5.8とBlender 5.2の公式MCPサーバーを使った。Blenderで木を作ってFBX形式で書き出し、Unreal Engineに取り込んで配置するタスクを、ローカルモデルで実行できたとのこと。
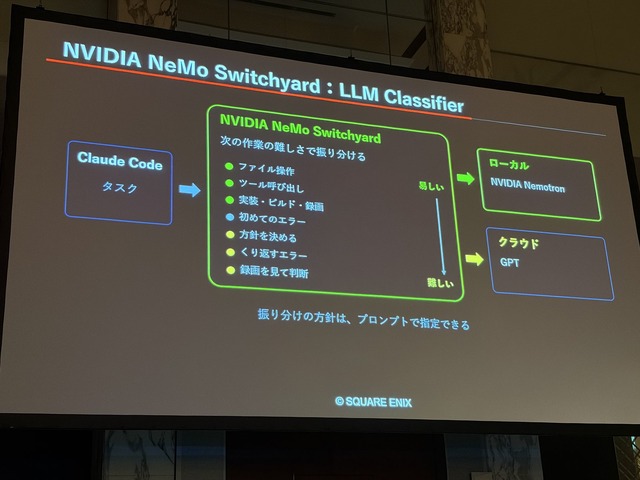
ツールを組み合わせてゲームを丸ごと作る試みは、難易度が高く、ローカルモデルだけでは完成しなかった。そこで藤井氏は、NVIDIA NeMo Switchyardを使った。Claude Codeから渡されるタスクを、難しさで振り分けるルーターである。ファイル操作、ツールの呼び出し、実装・ビルド・録画は易しい作業として、ローカルのNemotronに回す。方針の決定、繰り返し起きるエラーの対処、録画を見ての判断は難しい作業として、クラウドのGPTに回す。振り分けの方針はプロンプトで指定できる。
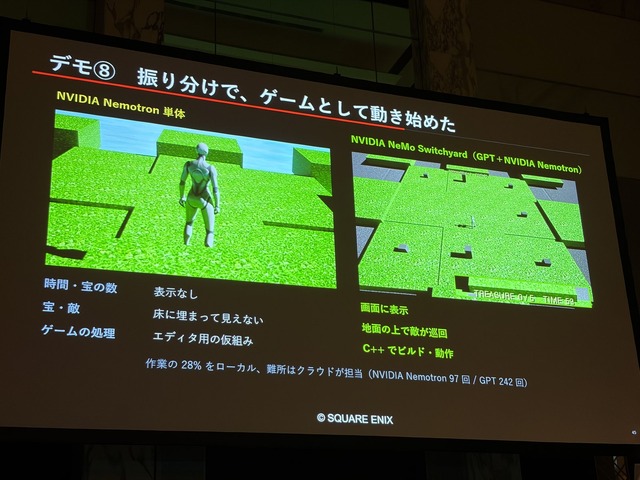
Nemotron単体では、時間や宝の数が画面に出ず、宝や敵が床に埋まって見えなかった。ゲームの処理もエディタ用の仮組みだった。振り分けを使うと、画面表示、地面の上を巡回する敵、C++でのビルドと動作がそろい、ゲームとして動き始めた。作業の28%をローカルが担い、呼び出しはNemotronが97回、GPTが242回である。
基本作業はローカルで動き、自由度の高い課題には確認の仕組みが要る
藤井氏は講演のまとめとして、3点を挙げた。
質問への応答、コード生成、制作ツールの操作まではローカルLLMで実行できた。
生成、検証、修正のサイクルは回せたが、動きの自然さや足の滑りには課題が残る。
他の作業でも使えるか、品質がどこまで保てるかを、引き続き試す。
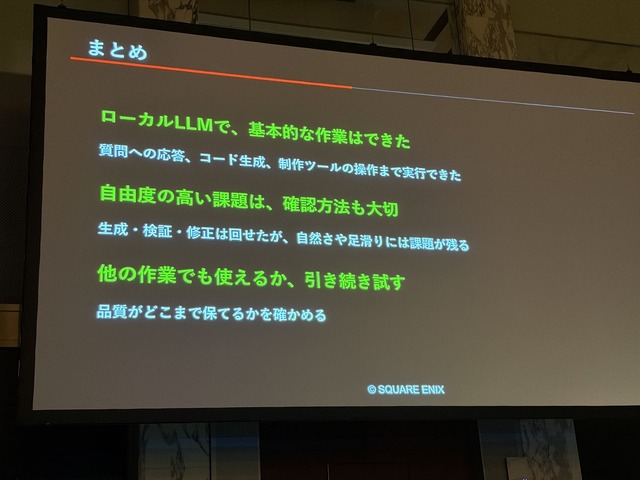
自由度の高い課題では、結果を確かめる方法を先に用意しておく必要がある。藤井氏は、ゲーム開発の難しいタスクでは、フロンティアモデルとの併用が必要になるという所感も示した。また、モーション生成がロボットや工場などの産業分野とも関連が深いとして、そうした現場での活用も呼びかけた。