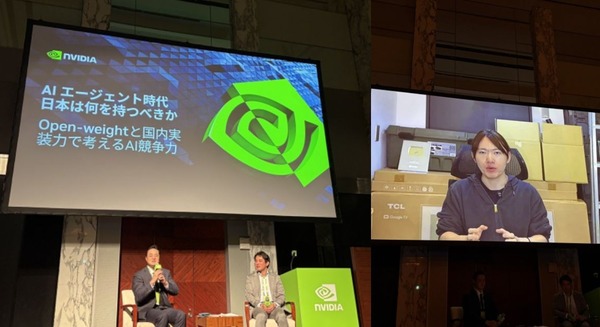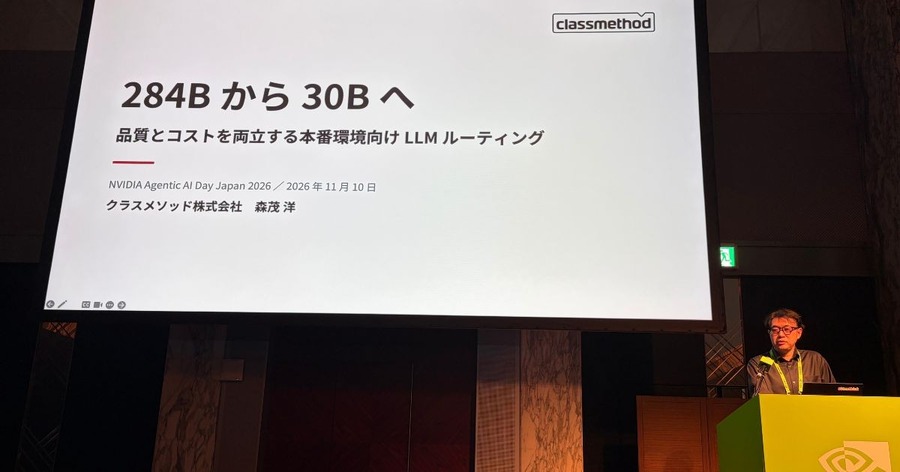
2026年11月10日、ザ・プリンス パークタワー東京で開かれた「NVIDIA Agentic AI Day Japan 2026」で、クラスメソッド株式会社の森茂洋氏が「284B から 30B へ - 品質とコストを両立する本番環境向け LLM ルーティング」と題した講演に登壇した。
複数のLLM(大規模言語モデル)から仕事ごとに適したものを選ぶ「ルーティング」で、選択を担う「判定役」のモデルを、パラメータ数284B(B は10億を表す単位)から30Bへ小さくした実証である。
1件の仕事で、モデルは何度も呼ばれる
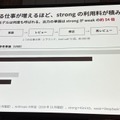
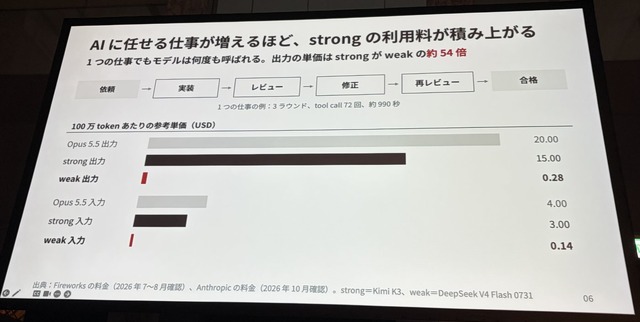
AIエージェントは、チャットのように1回聞いて1回答えて終わる仕組みではない。実装、レビュー、修正、再レビューと往復を重ねる。
往復が多いほど、モデルの単価差が総額に響く。講演では、高性能で単価の高いモデルを「strong」、安価なモデルを「weak」と呼んだ。strongにはKimi K3、weakにはDeepSeek V4 Flash 0731を使っている。100万トークン(モデルが扱う文字量の単位)あたりの出力単価は、strongが15.00米ドル、weakが0.28米ドルで、約54倍の開きがある。参考のClaude Opus 5.5は20.00米ドルで、weakとは70倍を超える差になる。
weakで足りる仕事は多いが、総費用は別の話になる
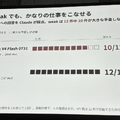
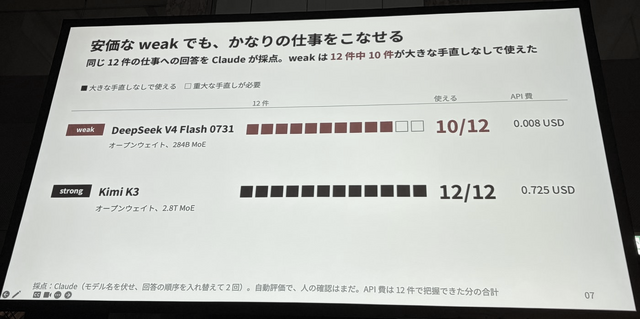
森茂氏は同じ12件の仕事をweakとstrongに解かせ、モデル名を伏せて回答の順序を入れ替えたうえで、Claudeに2回採点させた。大きな手直しなしで使えたのは、weakが12件中10件、strongが12件中12件である。API費は12件で把握できた分の合計で、weakが0.008米ドル、strongが0.725米ドルだった。採点は自動評価で、人による確認は済んでいない。
ただし、weakに寄せれば総費用が下がるとは限らない。別の仕事の例では、weakだけで進めると3ラウンドかかり、レビュー費が0.379米ドルに膨らんで合計0.398米ドルになった。strongだけなら1ラウンドで済み、実装0.284米ドルとレビュー0.106米ドルの合計0.390米ドルだったとのこと。
このため森茂氏は、weakへ送る割合を目標にしない方針を取った。strongも常に成功するわけではない。条件は、品質を保ったうえで、確認や修正を含む総費用を抑えることである。
判定役を284Bから30Bへ置き換える
今回使われたルーティングの仕組みは、NVIDIAのオープンソース「NVIDIA NeMo Switchyard」である。アプリやエージェントとモデルの間に置き、OpenAIやAnthropic互換のAPIで受けた依頼を、weakとstrongのどちらかへ振り分ける。方式には依頼文を読んで選ぶもの、作業の途中経過を見て選ぶもの、一定の割合で振るものがあり、今回は依頼文を読んで選ぶものを使ったという。
最初の判定役は、DeepSeek V4 Flash 0731(284B)だった。自分が解けるかどうかは自分が一番分かるはずだ、という仮説による。しかし判定役は、依頼が来るたびに回答の前で必ず動く。手元で動かすにはNVIDIA DGX Spark(NVIDIAの小型AIコンピュータ)が2台必要で、判定1回の所要時間は中央値2.2秒(87件、API経由で通信時間を含む)だった。
そこで、284Bを教師として判定を学習させた30Bの小型モデルに置き換えた。ベースはNVIDIA Nemotron 3.5 Lightning 30Bである。
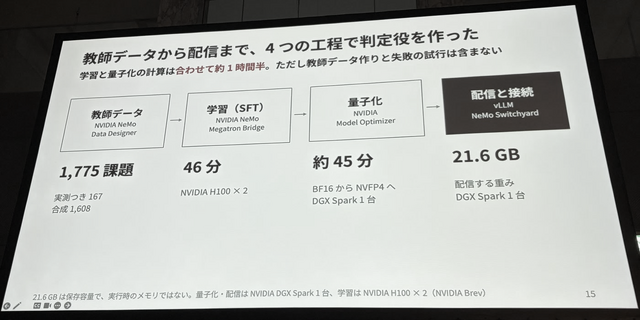
教師データは1,775課題である。うち167課題は実測つきで、LiveCodeBenchなどの公開ベンチマークに由来する。残る1,608課題は合成データである。
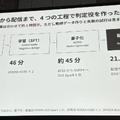
学習は教師ありファインチューニング(SFT、正解例を見せて学習させる手法)で、NVIDIA NeMo Megatron Bridgeを使い、NVIDIA H100を2基用いて46分で終えた。続いてNVIDIA Model Optimizerで、モデルを軽くする量子化(BF16からNVFP4)を、DGX Spark 1台で約45分かけて行った。配信する重みは21.6GBである。
判定精度は保たれたが、言えることには限りがある
評価用の237件で、判定をJSON形式で正しく出力できた件数は、学習前が212件、SFT後が237件、量子化後が236件だった。weakとstrongの判定が評価ラベルと一致した割合は、学習前の72.2%から、SFT後に81.4%、量子化後に82.6%へ上がった。森茂氏は、見ているのは評価ラベルとの一致であり、仕事の成功率ではないと断った。82.6%が81.4%より高くても、量子化で賢くなったとは言えないという。
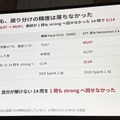
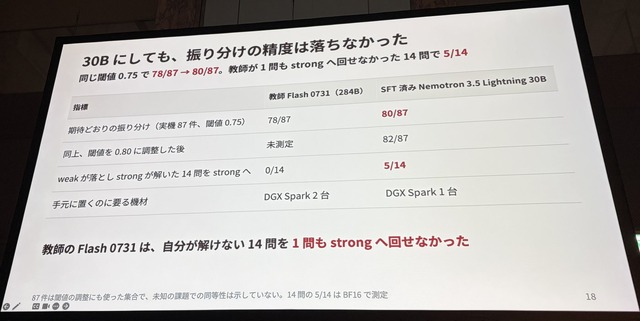
実機で解かせた87件(閾値0.75)では、期待どおりに振り分けられたのが教師の284Bで78件、30Bで80件だった。教師が2回続けて解けなかった14問をstrongへ回せたかを見ると、教師は0件、30Bは5件だった。教師は解けない問題も解けると見積もりがちで、30Bは実測から学んだ分だけ見極められた、というのが森茂氏の見立てである。
運用前に決めておく点
森茂氏は、実装に移す前に決めておく点を2つ挙げた。1つ目は、モデルを選び直す頻度である。今回は依頼ごとに選び直しているが、ツール呼び出しなど手続きの途中で送り先を変えると、同じ入力を繰り返す際のキャッシュが効かなくなり、費用がかさむ。
2つ目は、判定役にどこまで履歴を渡すかである。修正が続いて履歴が長くなり、入力の上限を超えて判定できない例が検証中に多く見られた。
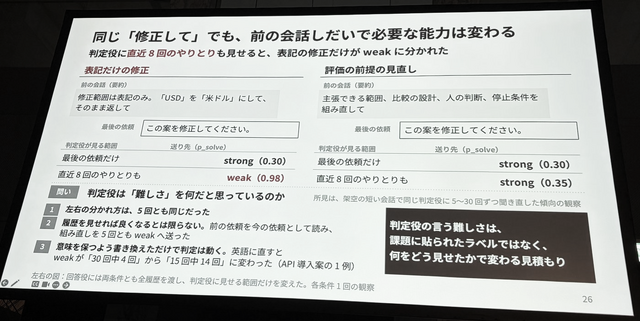
履歴の渡し方で、判定は変わる。最後の依頼が「この案を修正してください」の一文だけの場合、前の会話が表記の修正でも、前提の見直しでも、最後の依頼だけを見た判定役はどちらもstrongへ送った。直近8回のやりとりも渡すと、表記の修正はweak、前提の見直しはstrongに分かれた。いずれも架空の短い会話で、同じ判定役に5回から30回ずつ聞き直した傾向の観察である。森茂氏は、判定役の言う難しさは課題に貼られたラベルではなく、何をどう見せたかで変わる見積もりだと述べた。
製造業の問い合わせ対応から始める
自社の業務へ入れるなら、合格条件を決められ、結果を確かめる手段がある仕事から始めるのがよい、というのが森茂氏の提案である。製造業なら、点検手順の問い合わせや日報の要約が当てはまる。手順書と照合でき、保全担当者が確認できるためである。
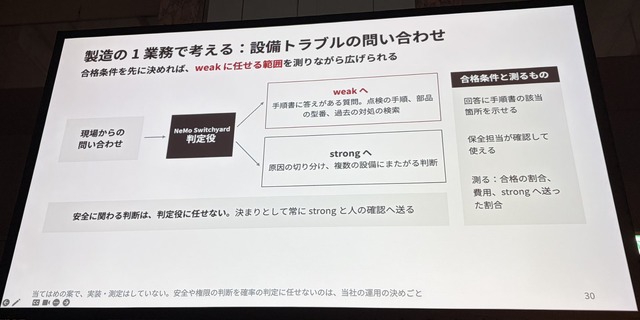
設備トラブルの問い合わせを例にすると、点検基準や部品の型番のように手順書に答えがある質問は、weakへ送る。原因の切り分けが必要な質問や、複数の設備にまたがる判断は、strongへ送る。安全に関わる判断は判定役に任せず、決まりとして常にstrongと人の確認へ回す。合格条件は、回答に手順書の該当箇所を示せて、保全担当者が確認して使えることである。合格の割合と費用を測りながら、weakに任せる範囲を広げていく。
まとめ
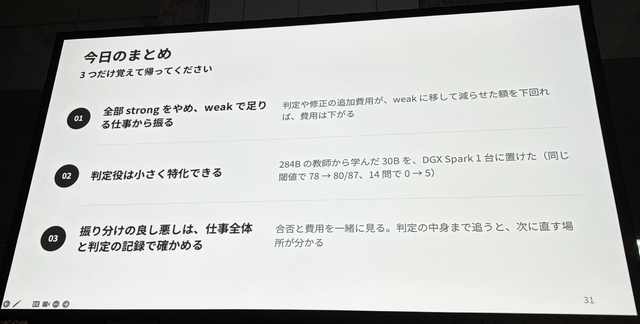
森茂氏がまとめとして挙げたのは、次の3点である。
1つ目は、すべてをstrongに任せるのをやめ、weakで足りる仕事から任せること。単価だけでなく、確認や修正まで含めた費用が下がるかを見る。2つ目は、判定役は小さく特化できること。284Bの教師から学んだ30Bを、DGX Spark 1台で動かせた。自社の課題で同じ結果になるかは、調べ直す必要がある。3つ目は、振り分けの良し悪しを、仕事全体と判定の記録で確かめることである。
最後に森茂氏は、まず小さな仕事を1つ選び、どこまでできたら合格かを決めてから試してほしいと呼びかけた。